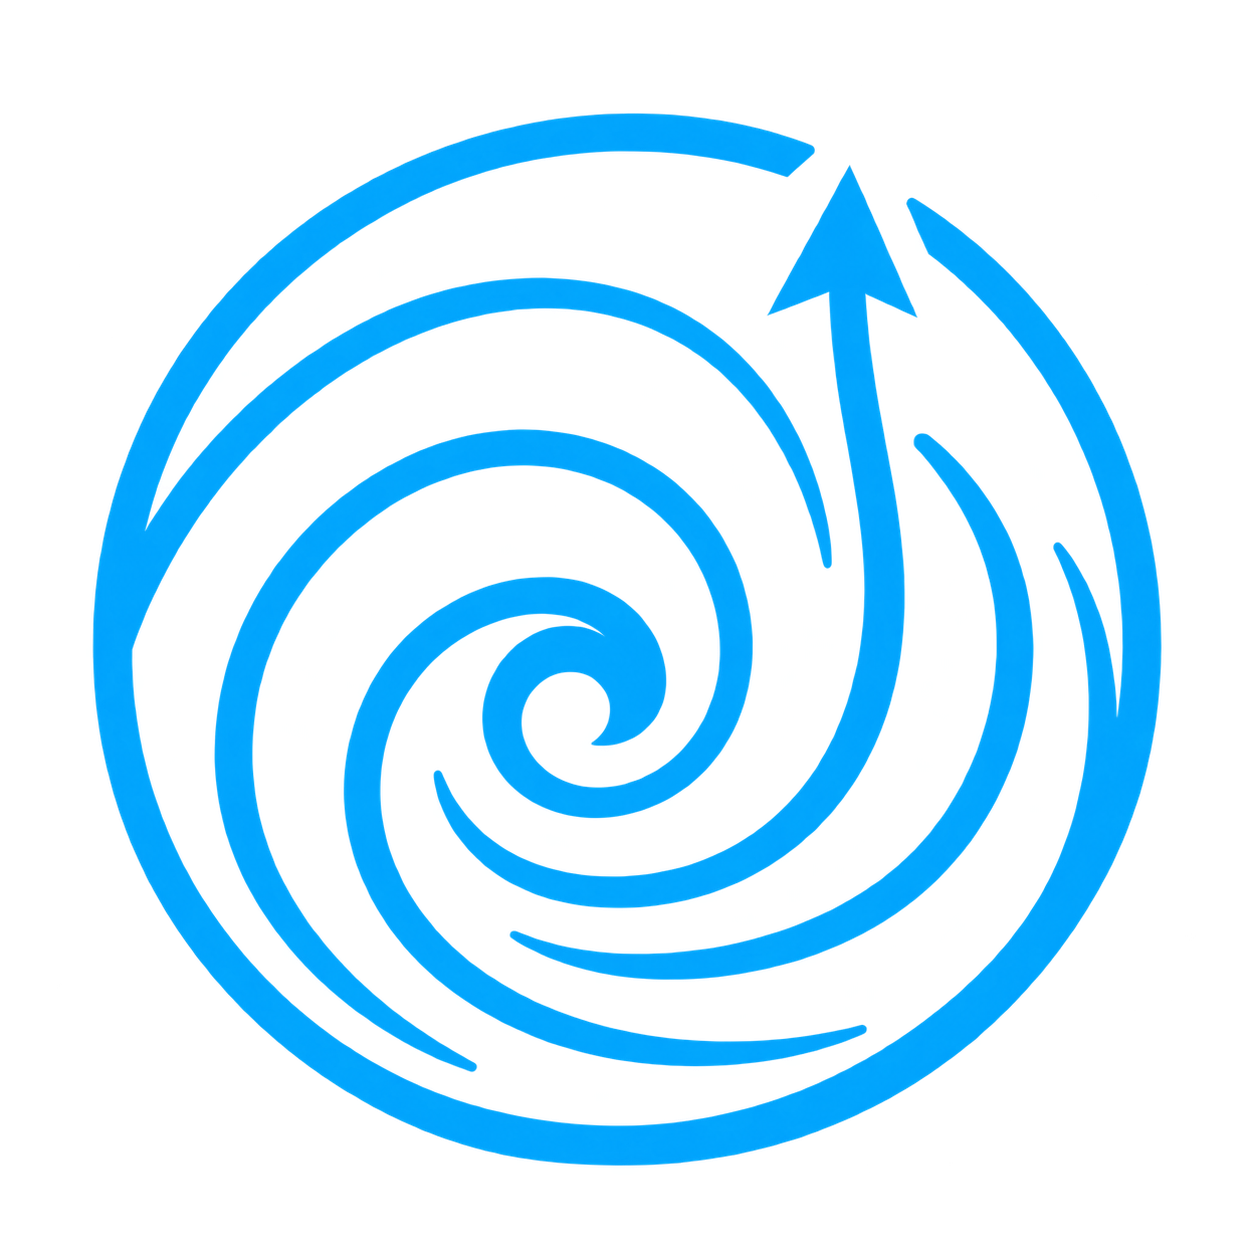
Das Vorhersagesystem ist eine Kette gekoppelter Schätzer und Modelle.
Beobachtungen liefern keine vollständige Atmosphäre, sondern unvollständige Projektionen des Zustands. Datenassimilation kombiniert sie mit einem Hintergrundzustand zur Analyse xᵃ samt Unsicherheitsbeschreibung Pᵃ. Das numerische Modell propagiert diese Analyse in die Zukunft; Ensembles repräsentieren einen Teil der Anfangs- und Modellunsicherheit. Produkte verdichten die resultierende Verteilung zu meteorologisch definierten Größen. Erst spätere Beobachtungen erlauben Verifikation und damit Rückmeldung an Kalibrierung, Parametrisierung und Systemdesign.
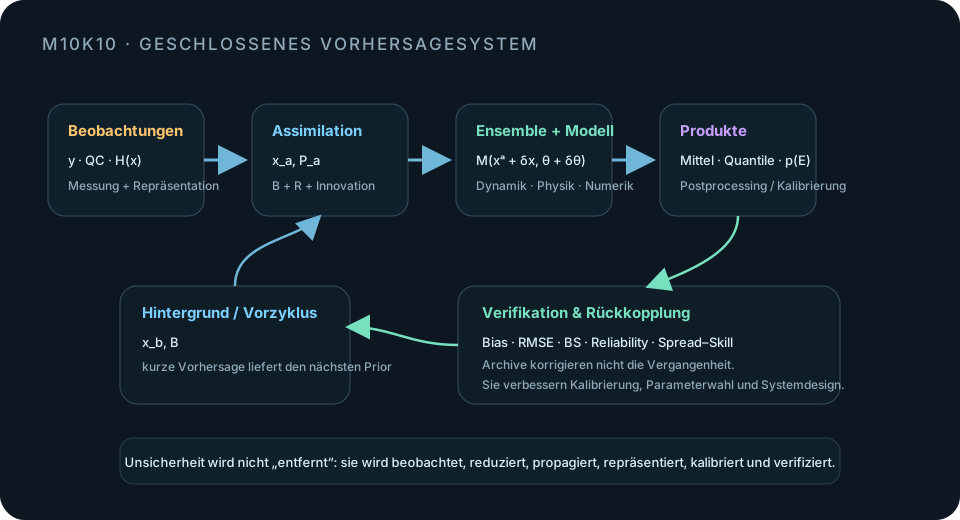
Der Startzustand ist eine Schätzung mit verbleibender Kovarianz, kein exakt bekannter Punkt.
Im skalaren linearen Gauß-Fall aus K06 seien Hintergrund und Beobachtung unabhängig mit Varianzen B=σᵦ² und R=σₒ². Dann gilt für den Gain und die Analysevarianz:
Je kleiner R relativ zu B, desto stärker folgt die Analyse der Beobachtung. Aber solange B und R endlich und positiv sind, bleibt Pᵃ>0. K10 behandelt genau diese Restunsicherheit als Startpunkt der Prognosekette.
Dynamisches Fehlerwachstum und Modellfehler sind verschiedene Beiträge zum Prognosebudget.
Ein reduziertes Varianzmodell schreibt die Prognoseunsicherheit als Summe zweier Beiträge:
G(T) beschreibt die Verstärkung anfänglicher Störungen durch die Dynamik; im Lab wird dafür G=eλT verwendet. Q(T) ist eine zusätzliche Modellfehlervarianz. Für unabhängige inkrementelle Modellfehler setzt das Lehrmodell Q(T)=σ²m,24·T/(24 h). Reale NWP-Fehler sind weder generell unabhängig noch stationär; die Gleichung ist deshalb ein transparentes Budget, keine operationelle Fehlerkovarianzformel.
Ein Ensemble approximiert die Forecast-Verteilung; Verifikation entscheidet, ob sein Spread glaubwürdig ist.
K08 zeigte, dass Member-Häufigkeiten endliche Stichproben einer Modellverteilung sind. Wenn das Ensemble im Rückblick unterdispersiv ist, können kalibrierte Produkte den Rohspread aufweiten; bei Überdispersion kann er verengt werden. Im K10-Lab steht dafür ein Faktor c:
Dieser Schritt ist bewusst als Postprocessing gekennzeichnet. Ein Faktor c>1 beweist nicht, dass eine bestimmte physikalische Fehlerquelle unterschätzt wurde; er sagt nur, dass das ausgegebene Wahrscheinlichkeitsmodell auf dem Verifikationsarchiv zu eng war.
Analysegewichtung, Fehlerwachstum, Modellfehler und Kalibrierung in einem einzigen konsistenten Budget koppeln.
Das Labor arbeitet mit einer standardisierten skalaren Zielgröße. Der Hintergrundmittelwert ist als Referenz xᵇ=0 gesetzt; die Innovation d=y−xᵇ verschiebt die Analyse. Die zentrale Forecast-Dynamik wird absichtlich als unverzerrte Persistenz des Analysemittels behandelt, damit ausschließlich die Unsicherheitskette sichtbar bleibt. Das Ereignis lautet X(T)>2.
Eine probabilistische Prognose ist erst dann belastbar, wenn ihre Wahrscheinlichkeiten über viele Fälle geprüft wurden.
K09 trennte Reliability, Resolution und Sharpness. Im Systemkontext bedeutet das: Der Rohspread eines Ensembles ist eine interne Eigenschaft des Forecast-Systems; erst Verification Pairs zeigen, ob dieser Spread zur tatsächlichen Fehlerverteilung passt. Kalibrierung kann systematische Fehlanpassungen korrigieren, muss aber mit unabhängigen Daten und stabilen Fallkollektiven geprüft werden.
Verifikation besitzt daher zwei Rollen: Qualitätskontrolle der aktuellen Produkte und Lernsignal für künftige Systemversionen. Sie ist kein nachträgliches „Tuning“ eines bereits verifizierten Falls.
Unsicherheit hat Herkunft, Struktur und Skala.
Mindestens fünf Klassen müssen auseinandergehalten werden: Beobachtungs- und Repräsentativitätsfehler, Restunsicherheit der Analyse, dynamisches Wachstum, struktureller Modell-/Parametrisierungsfehler und endliches Ensemble-Sampling. Zusätzlich entstehen Fehler bei Produktdefinition, Interpolation und Beobachtungszuordnung. Ein einziger Spread-Wert kann diese Quellen nicht kausal identifizieren.
Deshalb ist die Aussage „das Ensemble ist breit“ zunächst deskriptiv. Ob es angemessen breit ist und warum, ist eine Verifikations- und Diagnostikfrage.
Wahrscheinlichkeiten sind Information; Schwellenentscheidungen benötigen zusätzlich Konsequenzen und Kosten.
Ein Prognosesystem kann beispielsweise P(E)=35 % für ein klar definiertes Ereignis ausgeben. Ob daraus eine Warnung oder Handlung folgt, ist keine rein meteorologische Frage. Dafür braucht es eine Entscheidungsregel, die Fehlalarm- und Verpassungskosten, Exposition, Vorlaufzeit und mögliche Schutzmaßnahmen berücksichtigt.
K10 hält diese Ebenen getrennt: Forecast-Verteilung → kalibriertes Produkt → Entscheidung. Ein meteorologischer Probability-Wert ist nicht selbst eine Risikobewertung.
Jeder neue Analysezeitpunkt startet das Problem erneut — mit neuen Beobachtungen und einem Vorhersagehintergrund.
In einem zyklischen System wird eine kurze Vorhersage aus dem vorherigen Analysezeitpunkt zum Hintergrund xᵇ des nächsten Zyklus. Neue Beobachtungen korrigieren diesen Prior; anschließend startet die nächste Ensembleintegration. Fehler können sich dadurch über Zyklen fortpflanzen, aber Beobachtungen injizieren fortlaufend neue Information.
Das ist die operative Verbindung zwischen M09 und M10: Beobachtung und Vorhersage sind keine getrennten Welten, sondern zwei Richtungen desselben Zustandsabschätzungsproblems — Beobachtung konditioniert den aktuellen Zustand, Dynamik transportiert die bedingte Verteilung in die Zukunft.
M10 schließt mit einem Systembild: Zustand, Dynamik, Unsicherheit und Evidenz müssen gemeinsam geführt werden.
xᵃ ist ein geschätzter Anfangszustand mit Restunsicherheit Pᵃ.
Fehlerwachstum verstärkt Anfangsunsicherheit; Modellfehler fügt zusätzliche Varianz hinzu.
Mehrere Mitglieder approximieren eine bedingte Forecast-Verteilung, nicht mehrere unabhängige Wahrheiten.
Postprocessing kann Bias und Spread kalibrieren, ohne die zugrunde liegenden Fehlerquellen zu beseitigen.
Erst unabhängige Beobachtungen über viele Fälle zeigen Reliability und Skill.
Verifikation und neue Beobachtungen schließen den Zyklus und liefern Information für den nächsten Forecast.
Cross-References
M01–M10 bilden nun die vollständige Grundkette von Atmosphäre und Thermodynamik über Dynamik, Wetteranalyse und Beobachtung bis zur numerischen probabilistischen Vorhersage.