Unsicherheit wird durch mehrere konsistente Prognoseläufe repräsentiert.
Ein deterministischer Lauf startet aus einem einzigen analysierten Zustand x₀. Ein Ensemble verwendet dagegen N leicht verschiedene Anfangszustände und gegebenenfalls unterschiedliche Modellannahmen:
Die Störungen δx₀⁽ᵐ⁾ sollen nicht beliebig sein. Sie sollen relevante Analyseunsicherheit abbilden; Modellunsicherheit kann zusätzlich durch perturbierte Parameter, stochastische Physik oder unterschiedliche Modellkonfigurationen repräsentiert werden.
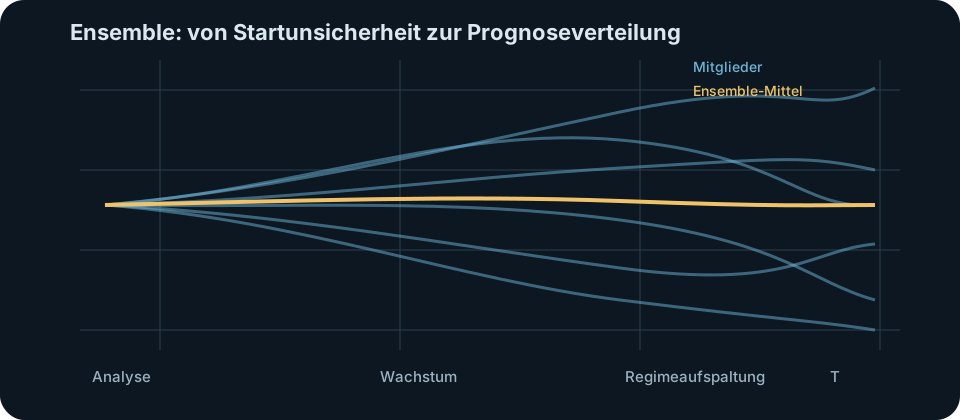
Ensemble-Mittel und Spread beschreiben verschiedene Eigenschaften der Verteilung.
Für eine skalare Prognosegröße q besitzt ein gleichgewichtiges Ensemble das Mittel
Das Mittel schätzt die Lage der Ensembleverteilung, der Spread ihre interne Streuung. Das Ensemble-Mittel muss selbst kein dynamisch realisierbares Mitglied sein — besonders bei multimodalen Verteilungen kann es zwischen zwei plausiblen Regimen liegen.
Wahrscheinlichkeit entsteht aus einer definierten Ereignismenge, nicht aus „Unsicherheit“ im Allgemeinen.
Für ein Ereignis E, etwa q(T)>q*, liefert ein gleichgewichtiges Ensemble die relative Häufigkeit
Bei N=20 kann p̂ nur in 5-Prozentpunkten springen. Diese Zahl ist eine Ensemblewahrscheinlichkeit: Sie ist nur dann als zuverlässige Ereigniswahrscheinlichkeit interpretierbar, wenn Ensembleerzeugung und Nachbearbeitung hinreichend kalibriert sind.
Ein Ensemble sampelt die Prognoseverteilung nur endlich.
Selbst bei perfekter Repräsentation ist eine relative Häufigkeit aus N Mitgliedern diskret und stichprobenabhängig. Sehr seltene Ereignisse können in kleinen Ensembles vollständig fehlen. Umgekehrt bedeutet 0/N nicht „physikalisch unmöglich“ und N/N nicht „sicher“.
Viele Lorenz‑63-Mitglieder integrieren und aus ihrer Endverteilung eine Ereigniswahrscheinlichkeit ableiten.
Das Labor benutzt wie K07 das Lorenz‑63-System als Lehrdynamik. Nach gemeinsamer Spin-up-Phase erhält jedes Mitglied eine deterministisch reproduzierbare Gauß-Störung in x; optional wird zusätzlich ρ perturbiert. Gezeigt werden die x-Trajektorien und die Verteilung von x(T). Das Ereignis lautet x(T)>x*.
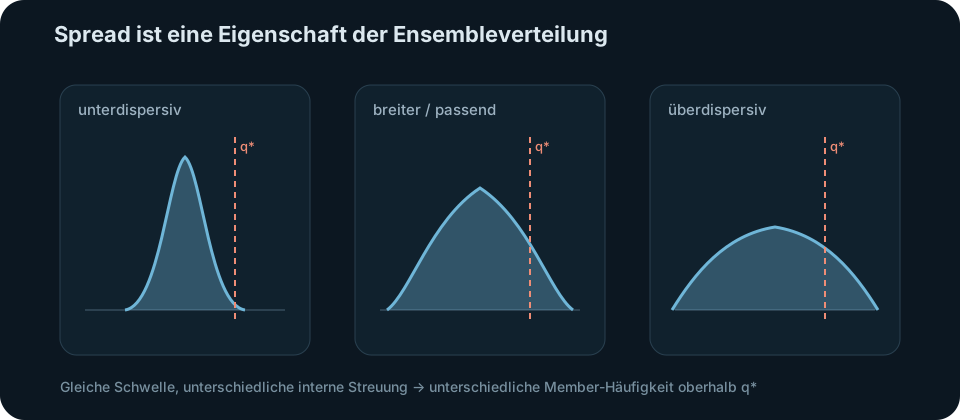
Mehr Spread bedeutet nicht automatisch mehr Fehler — aber fehlender Spread kann Unsicherheit unterschätzen.
Im idealisierten statistischen Sinn sollte ein Ensemble in Situationen mit großer tatsächlicher Prognoseunsicherheit stärker streuen als in gut vorhersagbaren Situationen. Diese Spread–Skill-Beziehung ist eine Kalibrierungsfrage über viele Fälle; sie lässt sich nicht aus einem einzelnen Forecast beurteilen.
Ein unterdispersives Ensemble ist zu eng und produziert typischerweise zu selbstsichere Wahrscheinlichkeiten. Ein überdispersives Ensemble ist zu breit. K09 wird dafür Verifikationsdiagnostik einführen.
Ensemble-Mitglieder sind Stichproben eines Modellkonstrukts.
Mitglieder teilen Beobachtungen, Assimilation, numerische Architektur und oft große Teile der Modellphysik. Sie sind deshalb nicht wie unabhängige Messungen der Zukunft zu interpretieren. Gemeinsame systematische Fehler können alle Mitglieder in dieselbe falsche Richtung verschieben.
Auch ein sehr großes Ensemble beseitigt keinen strukturellen Modellbias. Mehr Mitglieder reduzieren primär Sampling-Rauschen der dargestellten Modellverteilung.
Eine einzige Mittelwertkurve kann mehrere plausible Wetterregime verdecken.
Wenn Mitglieder in verschiedene dynamische Regime laufen, kann die Endverteilung zwei oder mehr Cluster besitzen. Dann sind Median, Quantile, Cluster oder Ereigniswahrscheinlichkeiten oft informativer als nur das arithmetische Mittel.
Genau hier wird K07 praktisch relevant: Nichtlineares Fehlerwachstum kann anfangs kleine Unterschiede in qualitativ verschiedene synoptische Entwicklungen übersetzen.
Eine Ensembleprognose ist eine bedingte Aussage über Modell, Initialisierung und Vorlaufzeit.
Die Aussage „30 % Wahrscheinlichkeit“ ist unvollständig ohne Definition von Variable, Schwelle, Ort/Region, Zeitfenster und Prognosesystem. Wahrscheinlichkeiten können außerdem nachkalibriert werden; operationelle Produkte sind daher nicht zwingend identisch mit rohen Member-Häufigkeiten.
K08 liefert die Verteilung. K09 fragt anschließend, ob diese Verteilung im Rückblick zuverlässig, scharf und nützlich war.
Ensembles übersetzen Anfangs- und Modellunsicherheit in eine prognostische Verteilung.
Mehrere plausible Start- und Modellzustände ersetzen die einzelne Trajektorie.
Das Ensemble-Mittel beschreibt Lage, ist aber nicht zwingend ein realisierbares Mitglied.
Interne Streuung misst Ensemblebreite, nicht direkt den tatsächlichen Fehler.
p̂=n/N ist eine endliche, kalibrierungsabhängige Ensemblehäufigkeit.
Multimodale Verteilungen können mehrere dynamisch plausible Entwicklungen enthalten.
K09 prüft deterministische und probabilistische Prognosen gegen Beobachtungen.
Cross-References
Wie werden deterministische und probabilistische Prognosen gegen Beobachtungen geprüft — und warum sind Bias, RMSE, Brier Score, Reliability und Sharpness unterschiedliche Qualitätsdimensionen?