Verifiziert wird ein definiertes Produkt — nicht der abstrakte Modellzustand.
Numerische Modelle liefern Gitterzustände und Ensemble-Mitglieder. Operationelle Produkte entstehen erst durch Auswahl, Interpolation, Diagnose, Aggregation oder statistische Nachbearbeitung: etwa 2‑m-Temperatur, 24‑h-Niederschlag, eine Windböen-Schwelle oder eine Ereigniswahrscheinlichkeit.
Jeder Verarbeitungsschritt verändert die Größe, die später verifiziert wird. Ein kalibriertes Wahrscheinlichkeitsprodukt darf deshalb nicht mit der Rohhäufigkeit des Ensembles verwechselt werden.
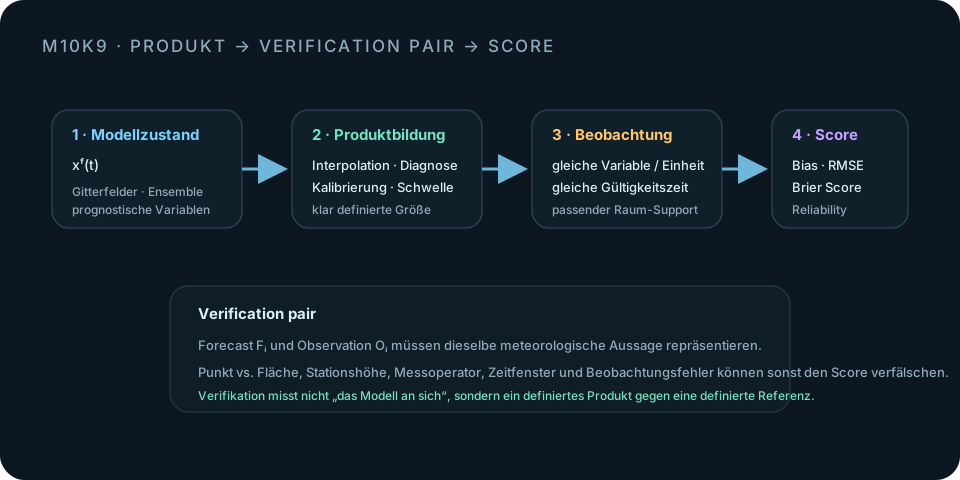
Zeit, Raum, Variable und Beobachtungsoperator müssen zusammenpassen.
Für jeden Fall i wird ein Forecast Fᵢ einer Referenz Oᵢ zugeordnet. Ein Stationswert ist jedoch kein Flächenmittel, Radar-Niederschlag kein perfekter Bodenwahrheitswert und ein Modellniveau nicht automatisch identisch mit einer Messhöhe. Vor einer Score-Berechnung muss daher geklärt sein, wie beide Größen vergleichbar gemacht wurden.
Auch die Beobachtung besitzt Fehler und Repräsentativitätsgrenzen. Ein gemessener Unterschied enthält daher nicht ausschließlich Modellfehler.
Bias misst systematische Verschiebung; RMSE misst die typische quadratische Fehlergröße.
Ein Bias nahe null kann durch positive und negative Fehler entstehen und bedeutet deshalb nicht, dass einzelne Prognosen gut waren. RMSE gewichtet große Fehler stärker als MAE. Der Vergleich zweier Systeme ist nur sinnvoll, wenn Fallkollektiv, Variable, Vorlaufzeit und Referenz identisch sind.
Für binäre Ereignisse bewertet der Brier Score die gesamte ausgegebene Wahrscheinlichkeit.
Für ein Ereignis E sei oᵢ=1, wenn es beobachtet wurde, sonst oᵢ=0. Eine Prognose gibt pᵢ∈[0,1] aus. Dann gilt
BS=0 ist perfekt. Ob ein gegebener Wert gut ist, hängt jedoch stark von Ereignishäufigkeit und Referenz ab. Ein Brier Skill Score kann deshalb relativ zu einem definierten Referenzsystem gebildet werden:
In diesem Kapitel-Lab ist die Referenz ausdrücklich die Stichproben-Klimatologie des betrachteten Fallkollektivs. Ein BSS ist damit kein universeller, zwischen beliebigen Datensätzen austauschbarer Qualitätswert.
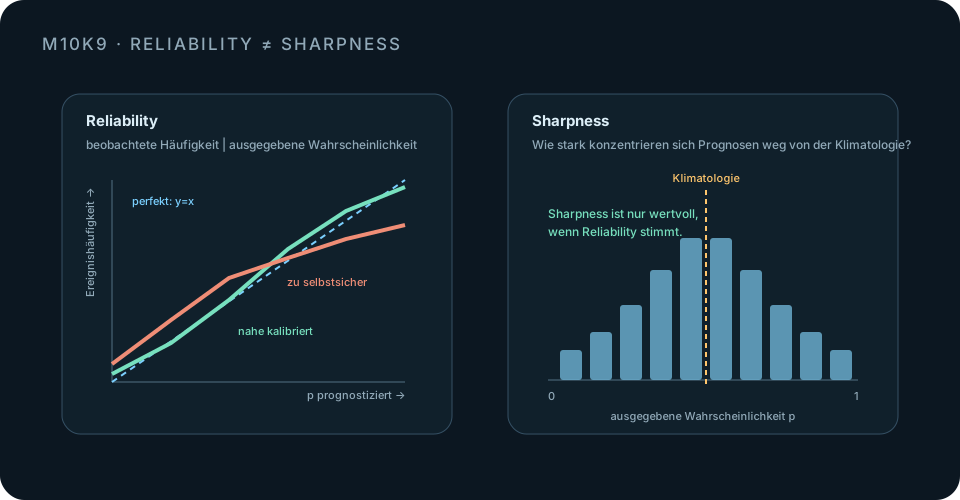
Kalibrierung und Entschiedenheit sind verschiedene Eigenschaften.
Reliability fragt: Wenn 30 % prognostiziert werden, tritt das Ereignis in vergleichbaren Fällen ungefähr in 30 % der Fälle ein? Resolution fragt, ob Prognosen unterschiedliche Ereignisraten verschiedener Situationen unterscheiden. Sharpness beschreibt ausschließlich die Verteilung der ausgegebenen Wahrscheinlichkeiten — also wie stark sie sich von der Klimatologie weg konzentrieren.
Sharpness ist eine Eigenschaft der Prognosen, nicht der Beobachtungen. Extremwerte nahe 0 oder 1 sind nur dann nützlich, wenn sie zugleich kalibriert sind.
Ein reproduzierbares Fallkollektiv erzeugen und deterministische wie probabilistische Diagnosen gleichzeitig beobachten.
Das Labor erzeugt für jeden Fall eine vorher bekannte großskalige Signalsituation μᵢ und anschließend eine synthetische Beobachtung Oᵢ = μᵢ + σₑ εᵢ. Die deterministische Prognose lautet Fᵢ = μᵢ + b. Für das Ereignis Oᵢ>q* wird eine Normalverteilung mit Zentrum Fᵢ und prognostiziertem Spread σₚ angenommen. Damit lassen sich Bias, tatsächliche Fehlerstreuung und angenommene Unsicherheit kontrolliert voneinander trennen.
Skill ist immer relativ zu einer expliziten Referenz.
Ein Score allein sagt nicht, ob ein komplexes System einen Mehrwert gegenüber einer einfachen Alternative besitzt. Referenzen können Klimatologie, Persistenz, ein älteres Modell oder ein anderes operationelles System sein. Die Referenz muss zur Fragestellung passen und für exakt dieselben Fälle ausgewertet werden.
Ein negativer BSS gegenüber Klimatologie bedeutet im definierten Datensatz lediglich: Der mittlere quadratische Probability-Fehler war größer als der dieser Referenz. Daraus folgt keine universelle Aussage über alle Variablen, Regionen oder Vorlaufzeiten.
Punktweise Scores können räumlich verschobene, aber strukturell plausible Wetterlagen hart bestrafen.
Ein Konvektionsband, das 30 km versetzt liegt, kann lokal große Gitterpunktfehler erzeugen, obwohl Struktur und Lebenszyklus meteorologisch ähnlich sind. Je nach Produkt werden deshalb zusätzlich räumliche, objektbasierte oder nachbarschaftsbasierte Verifikationsmethoden eingesetzt. Für synoptische Felder können andere Maße sinnvoll sein als für seltene Schwellenereignisse.
K09 beschränkt das Lab bewusst auf skalare Fälle, damit die Score-Logik transparent bleibt.
Verifikation ist ein statistisches Experiment und hängt vom Stichprobendesign ab.
Kurze Archive, seltene Ereignisse, Änderungen im Beobachtungssystem und Modellupdates können Stichproben inhomogen machen. Reliability-Bins mit wenigen Fällen sind stark verrauscht; selbst ein korrekt kalibriertes System liegt in endlichen Stichproben nicht exakt auf der Diagonalen.
Das Lab erzeugt unabhängige synthetische Fehler um ein bekanntes Signal. Reale Prognosefehler sind räumlich und zeitlich korreliert, zustandsabhängig und oft nicht normalverteilt.
Gute Verifikation trennt Definition, Referenz und Qualitätsdimension.
Bewertet wird eine exakt definierte Größe mit klarer Gültigkeitszeit und räumlichem Support.
Forecast und Beobachtung müssen meteorologisch vergleichbar gemacht werden.
Bias und RMSE beantworten unterschiedliche Fragen über Fehlerlage und Fehlergröße.
Brier Score bewertet Wahrscheinlichkeit und Ereignisausgang gemeinsam.
Reliability und Sharpness dürfen nicht zu einem einzigen Begriff vermischt werden.
K10 koppelt Analyse, Modell, Ensemble, Produkt und Verifikation zu einem vollständigen Vorhersagesystem.
Cross-References
Wie greifen Beobachtung, Datenassimilation, Modellintegration, Ensembles, Postprocessing und Verifikation in einem geschlossenen operationellen System zusammen?