Eine Anfangsanalyse ist ein fehlergewichteter Zustandsschätzer — weder reine Beobachtung noch reine Modellprognose.
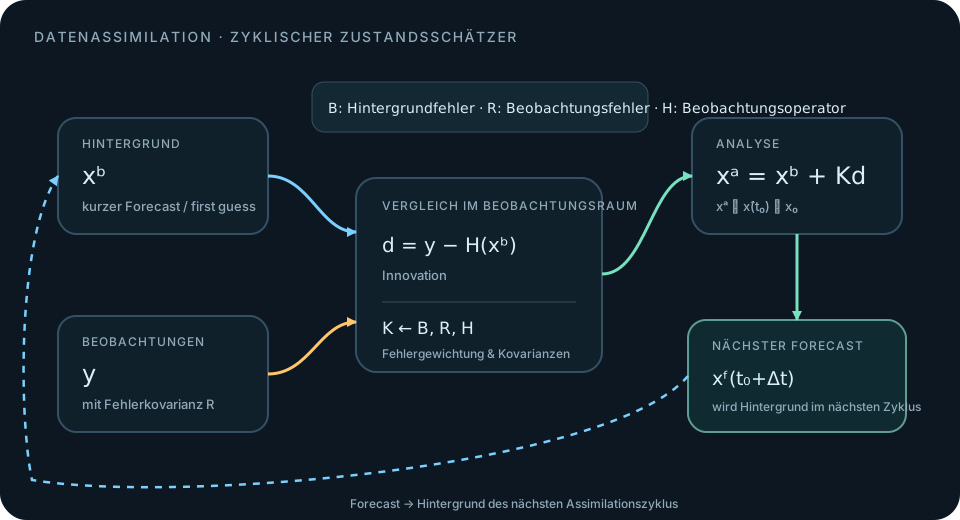
Numerische Modelle benötigen zu einem Startzeitpunkt einen vollständigen, dynamisch möglichst konsistenten Zustandsvektor. Beobachtungen sind dagegen räumlich und zeitlich unvollständig, messen unterschiedliche Größen und besitzen Mess- sowie Repräsentativitätsfehler. Deshalb beginnt ein Assimilationszyklus mit einem Hintergrundzustand xᵇ, meist einer kurzen Modellprognose aus dem vorherigen Zyklus.
Die Beobachtung y wird nicht direkt von xᵇ abgezogen. Der Beobachtungsoperator H projiziert den Modellzustand in den Beobachtungsraum. Erst dann ist die Innovation definiert:
Diese Schreibweise setzt die M09-Logik fort. Neu ist, dass die Innovation jetzt systematisch in ein Zustandsinkrement übersetzt wird.
Die Gewichtung hängt nicht nur von „Genauigkeit“ ab, sondern von Kovarianzen.
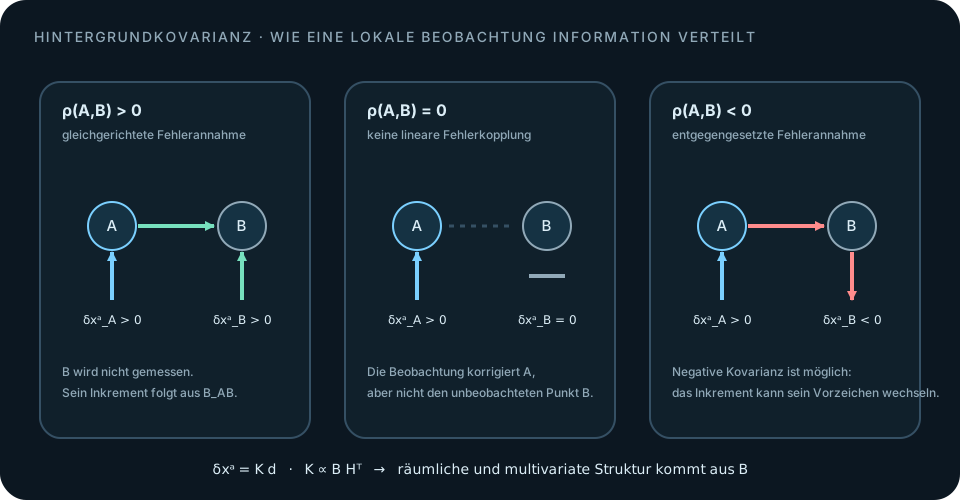
Im linearen Gauß-Fall werden Hintergrundfehler durch die Kovarianzmatrix B und Beobachtungsfehler durch R beschrieben. Diagonalelemente sind Fehlervarianzen; Nebendiagonalelemente beschreiben statistische Kopplungen. Damit kann eine Beobachtung nicht nur den direkt gemessenen Freiheitsgrad korrigieren, sondern über angenommene Fehlerkorrelationen auch andere Orte, Höhen oder Variablen beeinflussen.
xᵗ bezeichnet hier den unbekannten wahren Zustand und dient nur zur Definition der Fehlerstatistik. In der Realität ist B nicht aus dem aktuellen wahren Fehler bekannt; sie muss modelliert, klimatologisch geschätzt oder ensemblebasiert approximiert werden. Auch R umfasst mehr als reine Instrumentenspezifikationen, wenn Repräsentativitätsanteile im Beobachtungsfehler geführt werden.
Der Gain übersetzt eine Innovation aus dem Beobachtungsraum in ein Zustandsinkrement.
Für ein lineares Beobachtungsmodell und unverzerrte Gaußfehler lautet der klassische Minimum-Varianz-Gain
und die Analyse
Ist die Beobachtung relativ zum Hintergrund sehr präzise, wird das direkte Inkrement stärker beobachtungsnah. Ist die Hintergrundinformation relativ sicher, bleibt die Analyse näher an xᵇ. Entscheidend ist aber die Matrixstruktur: K ist kein einzelner Mischungsfaktor, sondern kann Information räumlich und zwischen Variablen verteilen. Nur der direkte skalare Gain des hier beobachteten Freiheitsgrads liegt zwischen 0 und 1; ein Kreuzkomponenten-Gain kann wegen der Kovarianz- und Skalierungsstruktur betragsmäßig auch größer als 1 sein.
Die zugehörige lineare Analysefehlerkovarianz kann kompakt als A = (I−KH)B geschrieben werden; numerisch robuste Implementierungen verwenden häufig äquivalente symmetrische Formen. Das Lehrmodell unten nutzt die exakt aus dem Zwei-Zustands-Fall abgeleiteten Varianzen.
Ein unbeobachteter Freiheitsgrad kann sich ändern, obwohl dort keine Messung vorliegt.
Angenommen, eine Temperaturbeobachtung liegt an Punkt A vor und Punkt B wird nicht beobachtet. Sind die Hintergrundfehler an A und B positiv korreliert, erzeugt eine positive Innovation an A typischerweise auch ein positives Inkrement an B. Bei Nullkorrelation bleibt B unverändert; bei negativer Korrelation kann das Inkrement an B das entgegengesetzte Vorzeichen besitzen.
Eine Beobachtung von A assimilieren — und beobachten, wie ρ den unbeobachteten Punkt B mitkorrigiert.
Das Lab arbeitet mit zwei Temperatur-Anomalie-Freiheitsgraden A und B relativ zum Hintergrundmittel. Nur A wird direkt beobachtet. Die Innovation d ist deshalb zugleich die Beobachtungsanomalie am Punkt A. Hintergrundstandardabweichungen σb,A, σb,B, Beobachtungsstandardabweichung σo und die Hintergrundfehlerkorrelation ρ definieren B und R.
Lehrgrenze: Das Lab ist ein exakt lösbarer linearer Zwei-Zustands-Fall. Es zeigt die Algebra von Gain, Kovarianzspread und Analysevarianz; es bildet weder Nichtlinearität noch reale Beobachtungsdichte, Bias-Korrektur oder hochdimensionale NWP-Matrizen ab.
3D-Var, 4D-Var und Ensemble-Verfahren lösen dasselbe Grundproblem mit unterschiedlicher Darstellung von Zeit und Fehlerstruktur.
| Familie | Grundidee | Charakteristische Stärke |
|---|---|---|
| 3D-Var | Analyse zu einem Referenzzeitpunkt durch Minimierung einer Kostenfunktion aus Hintergrund- und Beobachtungsabstand. | Klare variationale Formulierung; B meist vorgegeben oder hybridisiert. |
| 4D-Var | Beobachtungen innerhalb eines Zeitfensters werden über die Modelltrajektorie an den Analysezustand gekoppelt. | Zeitliche Dynamik ist Teil der Optimierung. |
| EnKF / EnVar | Ein Ensemble approximiert flussabhängige Fehlerkovarianzen und aktualisiert Zustand beziehungsweise variationale Kovarianz. | Wetterlagenabhängige Kovarianzstruktur; natürliche Brücke zu Ensembles. |
Operationelle Systeme kombinieren diese Ideen häufig. Die Namen bezeichnen daher keine einfache „Rangfolge“, sondern unterschiedliche algorithmische Realisierungen derselben Inferenzaufgabe.
Assimilation ist ein wiederholter Modell-Beobachtungs-Zyklus; systematische Fehler dürfen nicht als Wetterinkrement missverstanden werden.
Nach einer Analyse startet eine kurze Prognose. Diese wird im nächsten Assimilationsfenster zum Hintergrund. Dadurch propagiert das Modell Information in unbeobachtete Regionen, während neue Beobachtungen den Zustand erneut korrigieren. Datenalter und asynchrone Beobachtungszeiten sind deshalb methodisch relevant.
Vor dem Update stehen Qualitätskontrolle, Beobachtungsoperatoren und gegebenenfalls Bias-Korrektur. Ein systematischer Satellitenkanal-Bias ist kein zufälliger Beobachtungsfehler; würde er ungeprüft assimiliert, könnte das System wiederholt denselben künstlichen Zustandstrend erzeugen. Umgekehrt darf eine große Innovation nicht allein aufgrund ihrer Größe als Messfehler verworfen werden — sie kann echte, im Hintergrund fehlende Struktur enthalten.
Auch nach Assimilation bleibt Anfangszustandsunsicherheit übrig.
Die Analyseunsicherheit sinkt dort, wo Beobachtungen tatsächlich Information hinzufügen, verschwindet aber nicht. Fehler in B, R oder H, nicht beobachtete Freiheitsgrade, Modell-Bias, Repräsentativitätsprobleme und Nichtlinearitäten begrenzen die Rekonstruktion. Ein formal kleines Analysevarianzmaß ist außerdem nur innerhalb des angenommenen Fehlermodells aussagekräftig.
Damit schließt sich die Brücke zu K01: Der Prognosestart x₀ ≡ xᵃ ≡ x̂(t₀) ist die bestmögliche Zustandsschätzung im verwendeten System — nicht der unbekannte exakte Atmosphärenzustand.
K06 erklärt die Entstehung von x₀; K07 fragt, wie kleine verbleibende Fehler unter nichtlinearer Dynamik wachsen.
Auch ein gut assimiliertes Anfangsfeld enthält einen Fehler δx₀. Die Atmosphäre und das Modell wirken nicht auf alle Fehlerkomponenten gleich: Manche Störungen zerfallen, andere wachsen rasch entlang instabiler Richtungen des Zustandsraums. Diese Sensitivität führt zum Thema von K07: Fehlerwachstum, Chaos und endliche Vorhersagbarkeit.
Datenassimilation erzeugt den prognosefähigen Anfangszustand durch fehlergewichtete Kombination von Modell und Beobachtung.
xᵇ liefert einen vollständigen first guess und dynamischen Kontext.
d = y − H(xᵇ) vergleicht Beobachtung und Modell im selben Beobachtungsraum.
B und R bestimmen Stärke, Reichweite und Kopplung des Updates.
K überführt Beobachtungsinformation in ein multivariates Zustandsinkrement.
xᵃ ≡ x̂(t₀) wird als x₀ in die Prognose integriert, bleibt aber unsicher.
Verbleibende Anfangsfehler entwickeln sich unter nichtlinearer Dynamik unterschiedlich stark.
Cross-References
Warum wachsen manche kleine Anfangsfehler rasch, andere kaum — und weshalb besitzt deterministische Wettervorhersage einen endlichen Vorhersagehorizont?